
Invidious pozwala oglądać YouTube bez reklam i śledzenia, ale niczego nie przechowuje. Gdy autor usunie film, znika on także z Invidious. Ten wpis opisuje dwa narzędzia, które zapisują filmy na własnym dysku:
- MeTube pobiera pojedynczy film lub playlistę z wklejonego linku.
- Tube Archivist subskrybuje kanały i sam pobiera nowe filmy, tworząc lokalne archiwum z odtwarzaczem.
YouTube często zmienia player i zabezpieczenia przed botami, przez co pobieranie co jakiś czas przestaje działać. Oba narzędzia korzystają z yt-dlp, którego poprawki pojawiają się zwykle w ciągu kilku dni. Dlatego te kontenery trzeba regularnie aktualizować, najlepiej automatycznie przez Watchtower .
MeTube
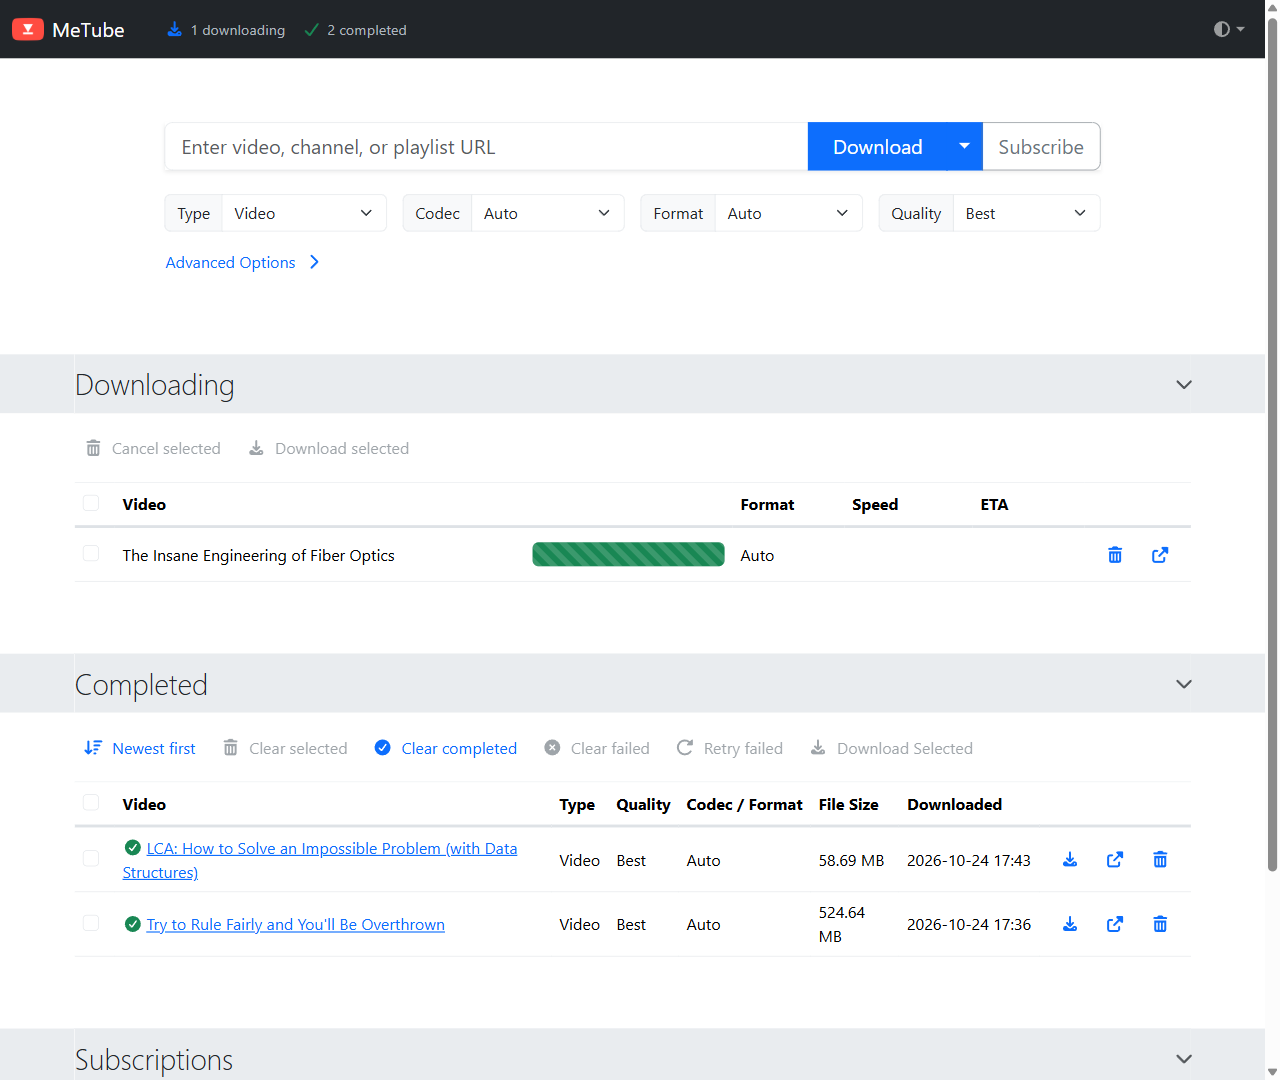
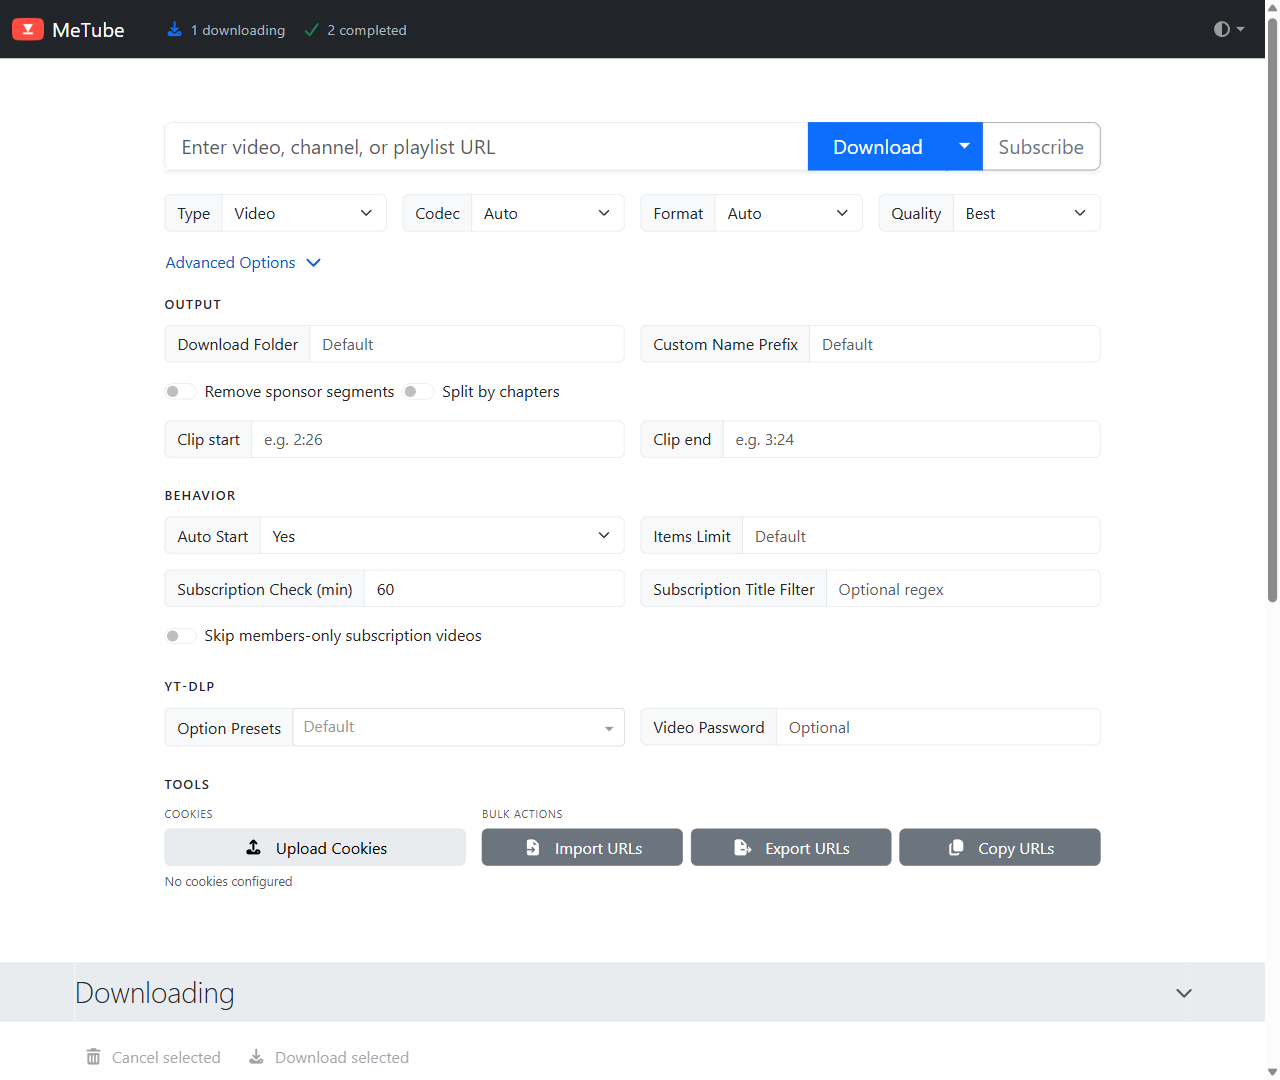
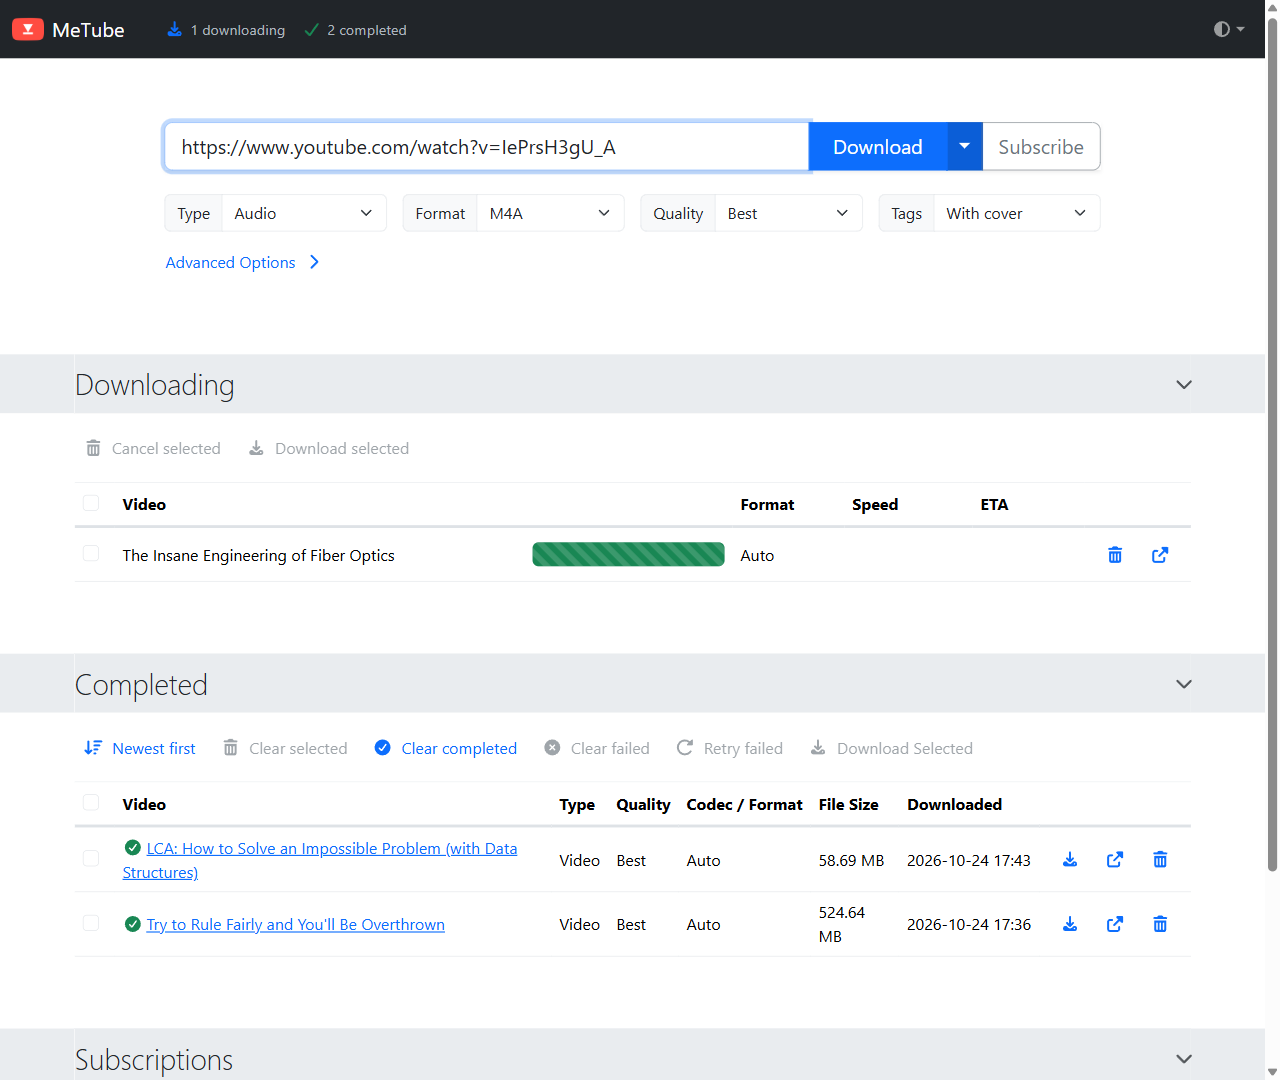
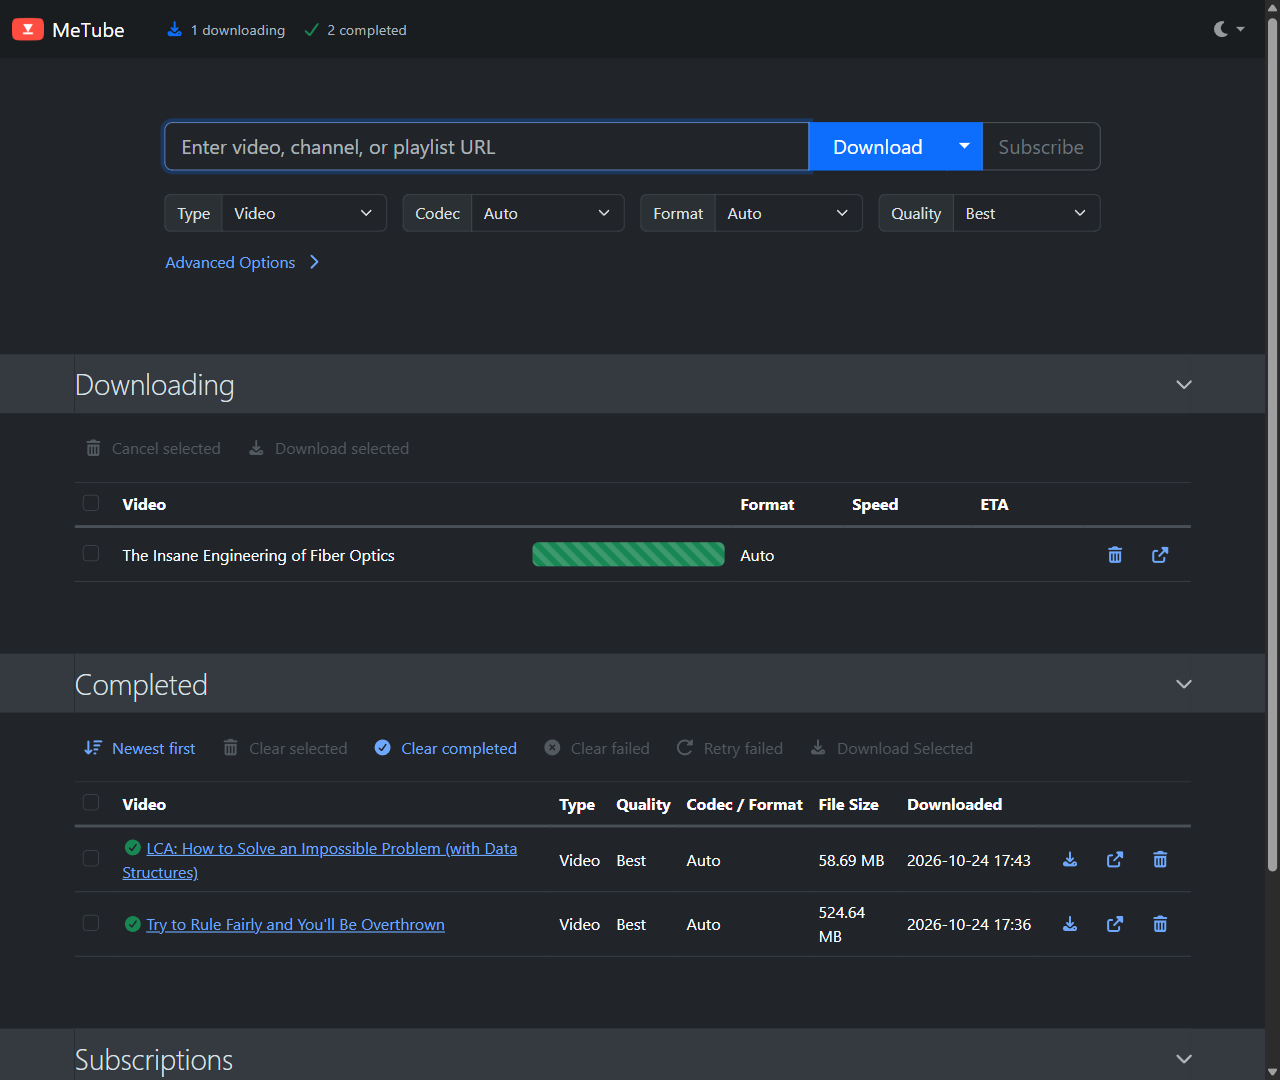
MeTube rozwiązuje prosty problem: chcę mieć konkretny film na dysku, np. wykład do obejrzenia offline albo utwór jako plik audio. Wklejam link w przeglądarce, wybieram jakość i format, a plik ląduje w katalogu na serwerze. Działa nie tylko z YouTube, ale też z kilkuset innymi serwisami.
services:
  metube:
    image: alexta69/metube
    container_name: metube
    restart: unless-stopped
    volumes:
      - ./downloads:/downloads
    networks: [proxy]

networks:
  proxy:
    external: true
Tube Archivist
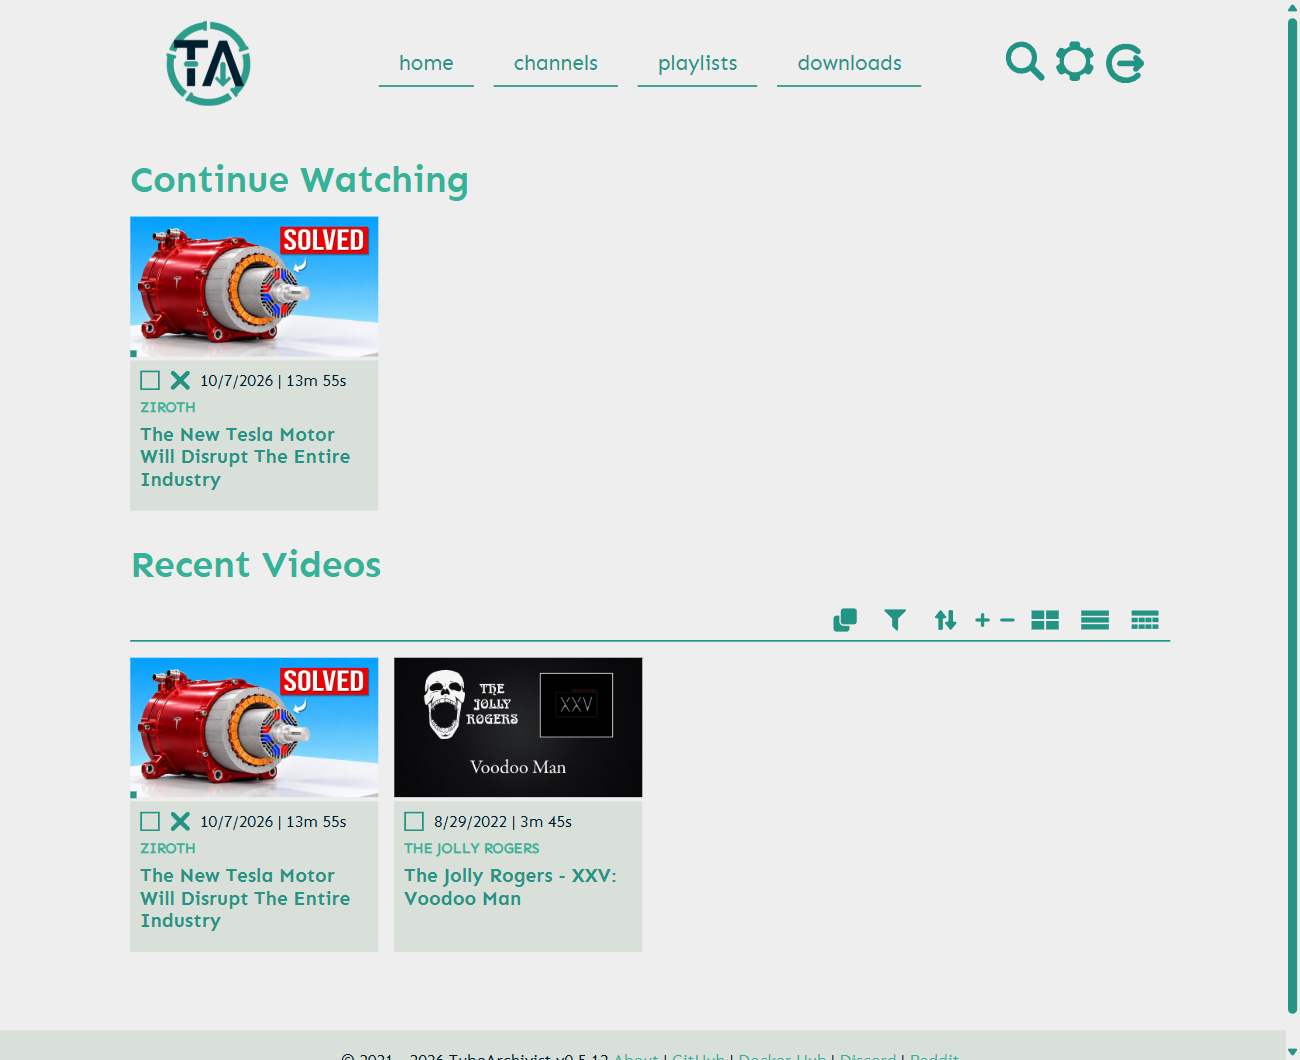
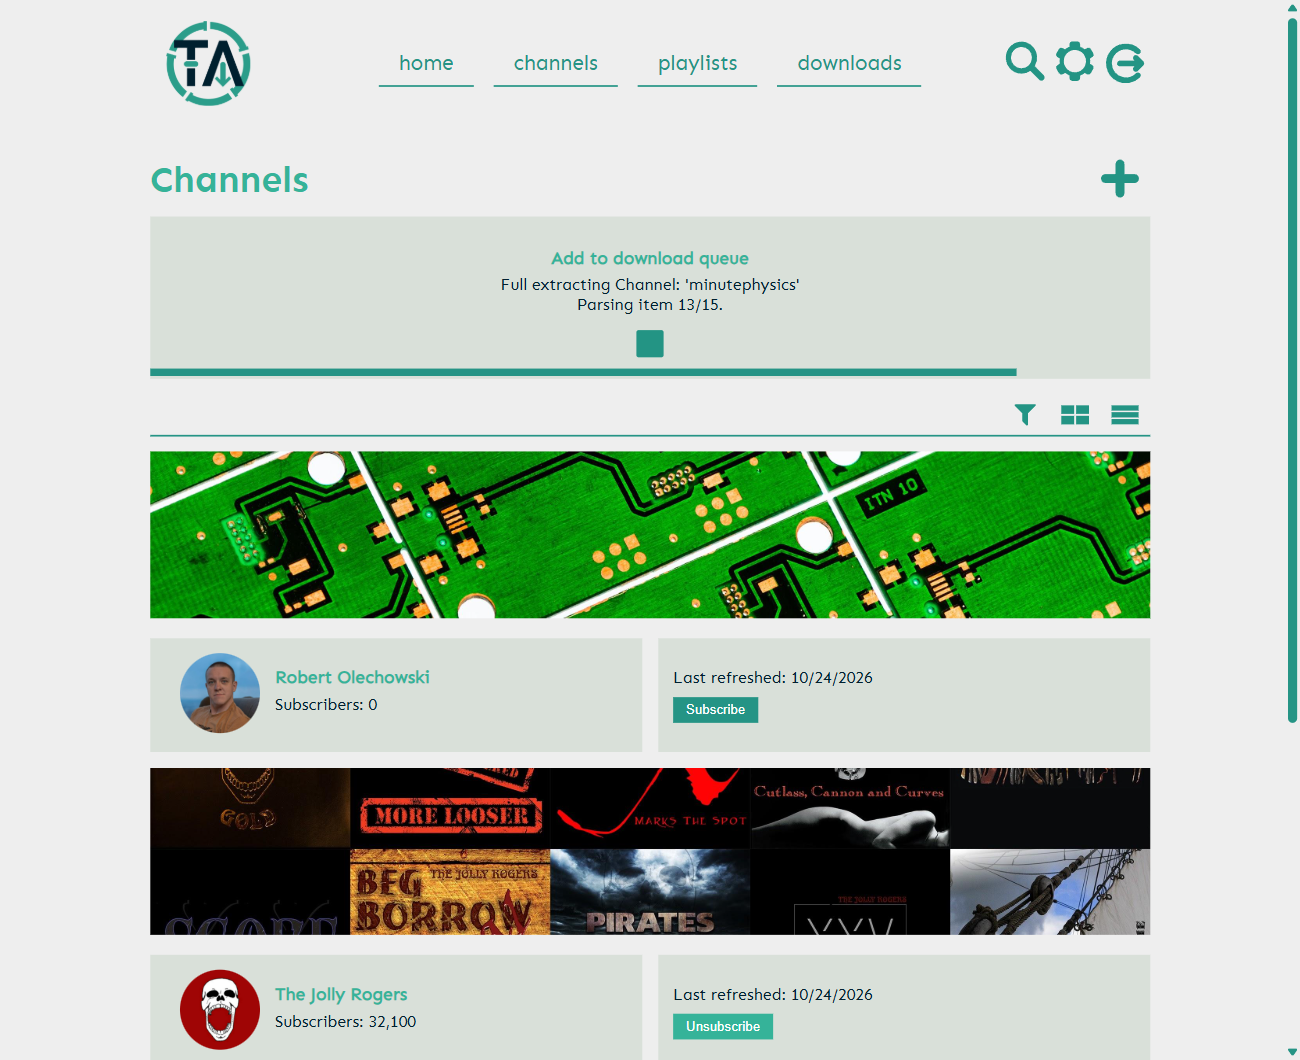
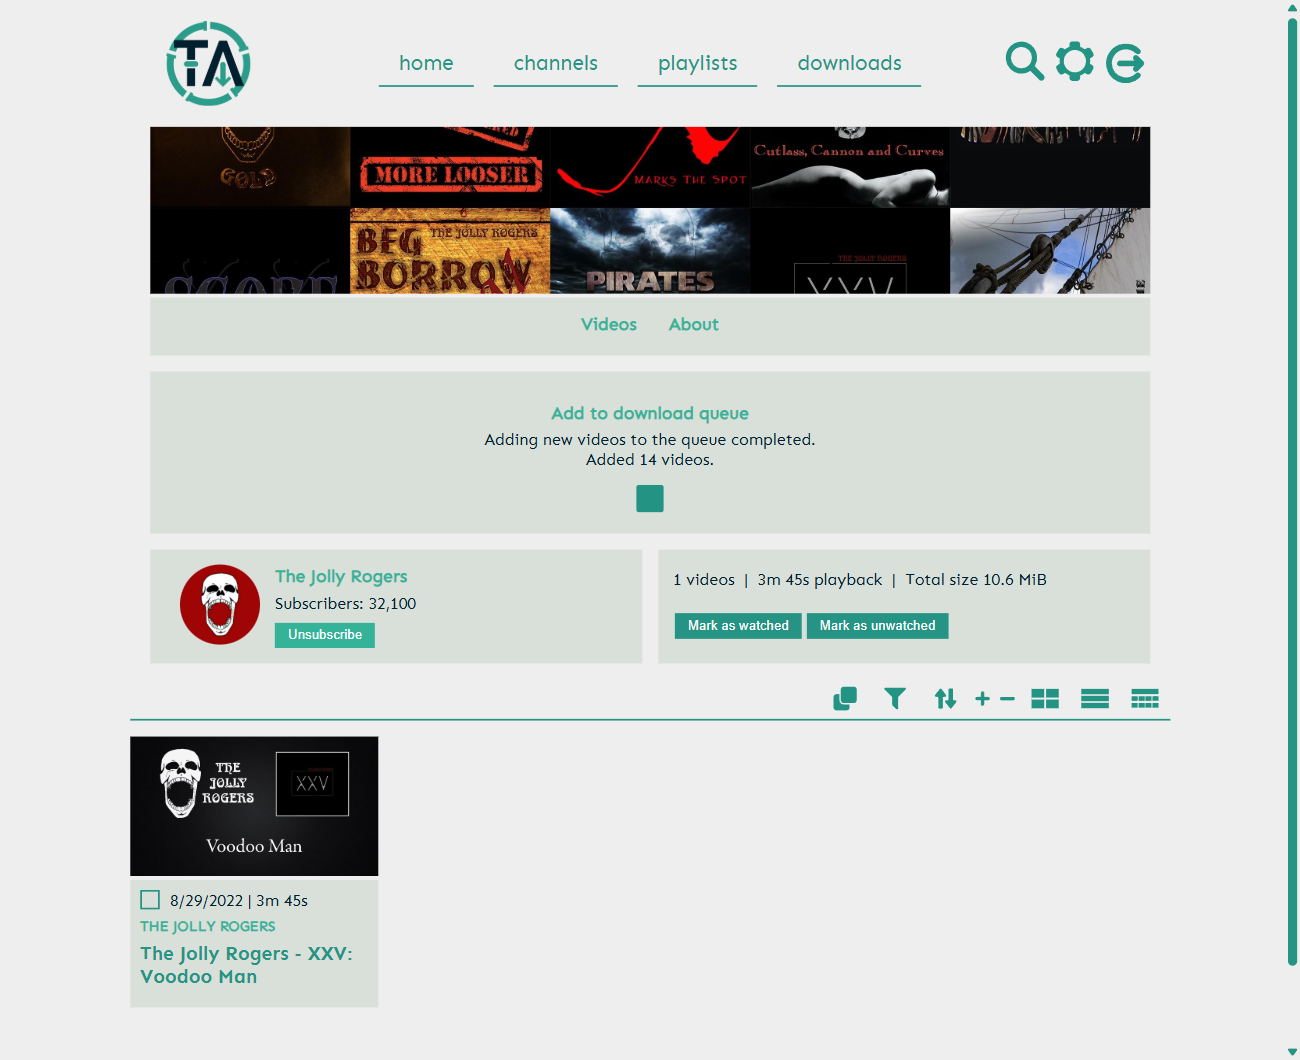
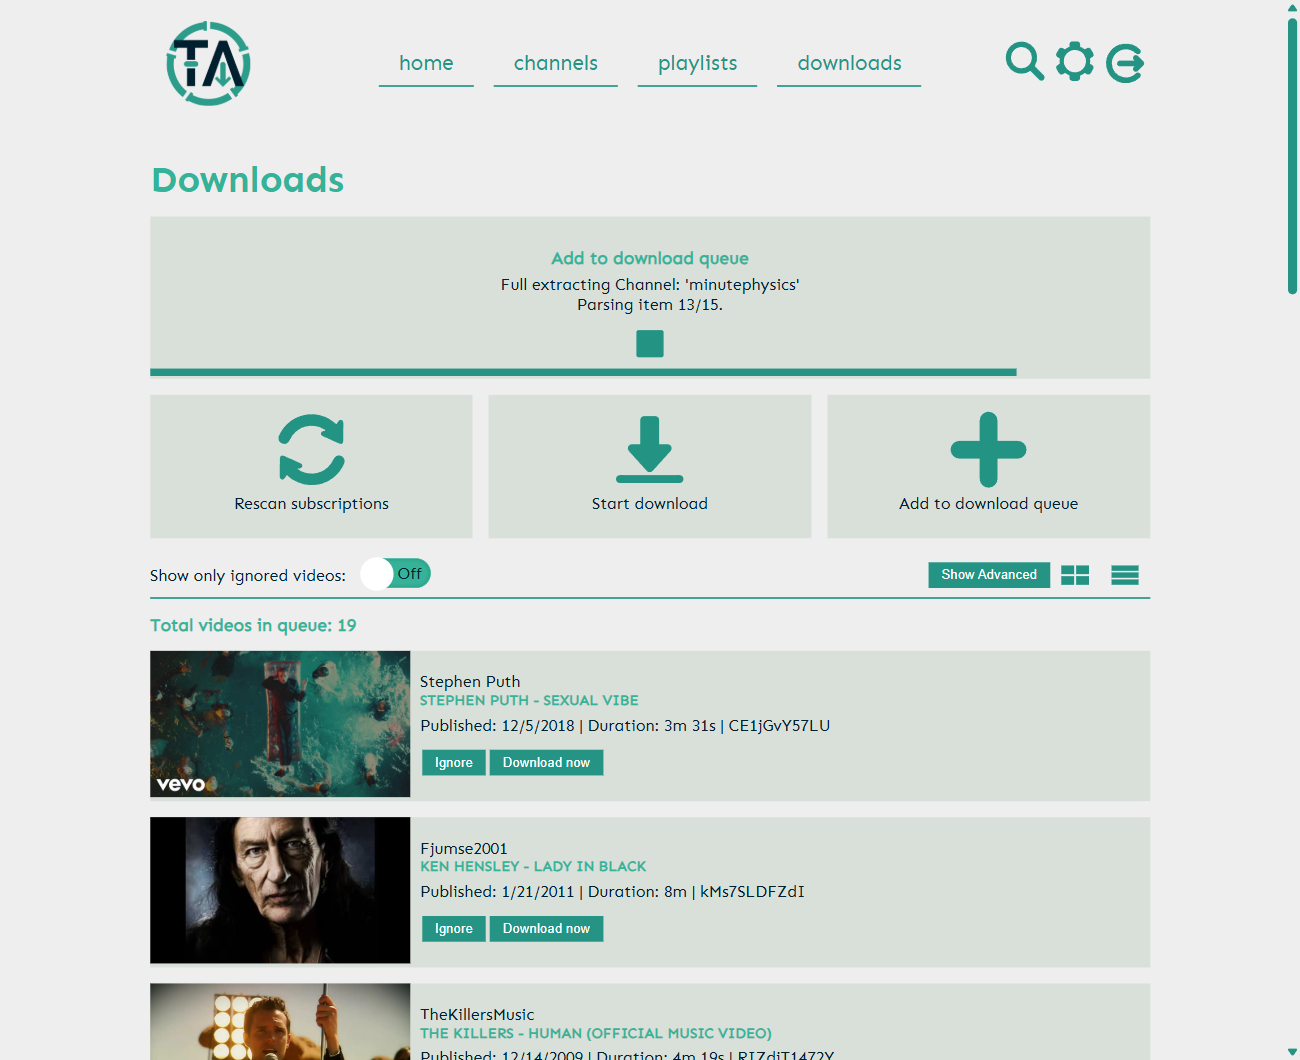
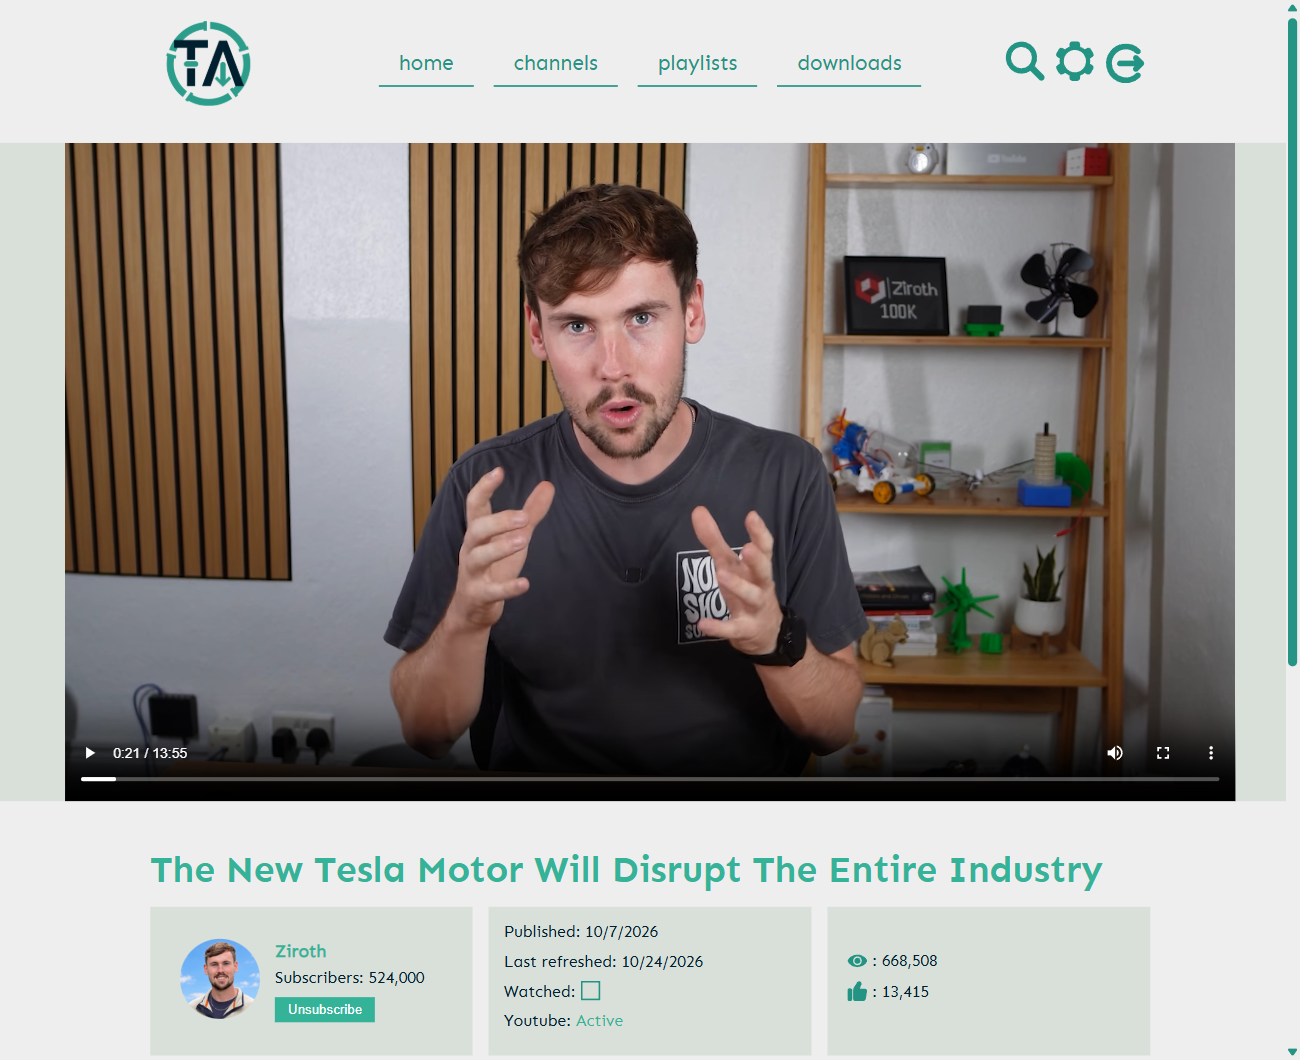
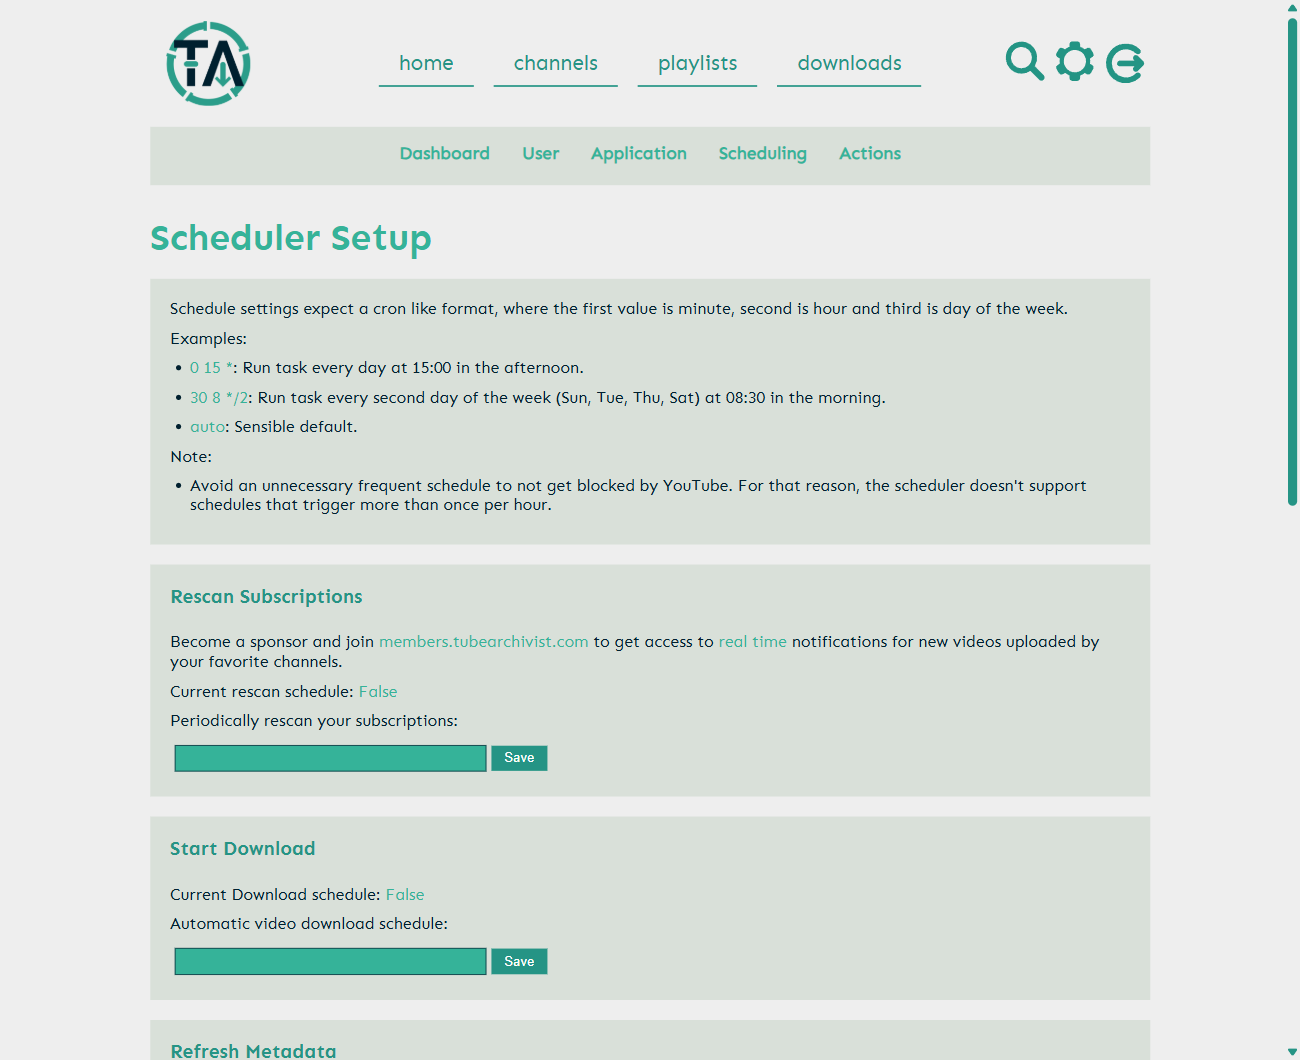
Tube Archivist to mini YouTube działający lokalnie. Subskrybuję w nim kanały i playlisty, a aplikacja według harmonogramu synchronizuje je z YouTube i pobiera nowe filmy na dysk serwera. Potem całe archiwum przegląda się w interfejsie podobnym do YouTube: strona główna z najnowszymi filmami, widoki kanałów i playlist, odtwarzacz, wyszukiwarka, historia obejrzanych. Filmy zostają na dysku nawet wtedy, gdy autor usunie je z YouTube.
Konfiguracja składa się z trzech kontenerów:
| Kontener | Funkcja |
|---|---|
tubearchivist | Aplikacja webowa z interfejsem i odtwarzaczem. Planuje synchronizację kanałów i pobiera filmy przez yt-dlp. |
archivist-redis | Redis z kolejką zadań: pobierania, skanowania subskrypcji i zadań harmonogramu. |
archivist-es | Elasticsearch z indeksem metadanych filmów, kanałów i playlist. Na nim działa wyszukiwarka. |
services:
  tubearchivist:
    image: bbilly1/tubearchivist:latest
    container_name: tubearchivist
    restart: unless-stopped
    env_file: .env
    environment:
      ES_URL: http://archivist-es:9200
      REDIS_CON: redis://archivist-redis:6379
      HOST_UID: "1000"
      HOST_GID: "1000"
      TA_HOST: http://tubearchivist.mini-1.lan
      TA_USERNAME: robert
      TZ: Europe/Warsaw
    volumes:
      - /home/robert/data/tubearchivist/media:/youtube
      - /home/robert/data/tubearchivist/cache:/cache
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/api/health/"]
      interval: 2m
      timeout: 10s
      retries: 3
      start_period: 30s
    depends_on:
      - archivist-es
      - archivist-redis
    networks: [proxy, default]
    deploy:
      resources:
        limits:
          memory: 2G
          cpus: "2.0"

  archivist-redis:
    image: redis:7-alpine
    container_name: archivist-redis
    restart: unless-stopped
    volumes:
      - /home/robert/data/tubearchivist/redis:/data
    networks: [default]
    deploy:
      resources:
        limits:
          memory: 256M

  archivist-es:
    image: bbilly1/tubearchivist-es:latest
    container_name: archivist-es
    restart: unless-stopped
    environment:
      ELASTIC_PASSWORD: ${ELASTIC_PASSWORD}
      ES_JAVA_OPTS: "-Xms1g -Xmx1g"
      xpack.security.enabled: "true"
      discovery.type: single-node
      path.repo: /usr/share/elasticsearch/data/snapshot
    ulimits:
      memlock:
        soft: -1
        hard: -1
    volumes:
      - /home/robert/data/tubearchivist/es:/usr/share/elasticsearch/data
    networks: [default]
    deploy:
      resources:
        limits:
          memory: 2G
          cpus: "1.0"

networks:
  proxy:
    external: true
Hasła trzymane są w pliku .env poza repozytorium:
TA_PASSWORD=<haslo-do-konta-w-tube-archivist>
ELASTIC_PASSWORD=<losowy-ciag>     # openssl rand -hex 16
Elasticsearch w kontenerze działa jako użytkownik o UID 1000, więc katalog z bind mounta musi do niego należeć. Inaczej archivist-es przerwie start z błędem uprawnień:
mkdir -p /home/robert/data/tubearchivist/es
sudo chown -R 1000:1000 /home/robert/data/tubearchivist/es
| Zmienna | Opis |
|---|---|
ES_URL | Adres Elasticsearch, tu http://archivist-es:9200. |
REDIS_CON | Adres Redisa, tu redis://archivist-redis:6379. |
TA_HOST | Pełny adres, pod którym aplikacja jest otwierana w przeglądarce. Inny adres kończy się błędem przy logowaniu. |
TA_USERNAME | Login konta tworzonego przy pierwszym starcie. |
TA_PASSWORD | Hasło tego konta (w .env). Później zmienia się je już w panelu aplikacji. |
ELASTIC_PASSWORD | Hasło do Elasticsearch (w .env). Czytają je oba kontenery: archivist-es i tubearchivist. |
HOST_UID, HOST_GID | Właściciel pobranych plików na hoście. |
TZ | Strefa czasowa, według której działa harmonogram synchronizacji. |
ES_JAVA_OPTS | Rozmiar heapu Elasticsearch, tu 1 GiB. |
discovery.type, xpack.security.enabled | Pojedynczy węzeł Elasticsearch z włączonym uwierzytelnianiem. |
Katalog media/ rośnie szybko, bo każdy subskrybowany kanał dokłada pełne pliki wideo. Warto od razu ograniczyć w ustawieniach maksymalną rozdzielczość i liczbę filmów pobieranych z kanału.